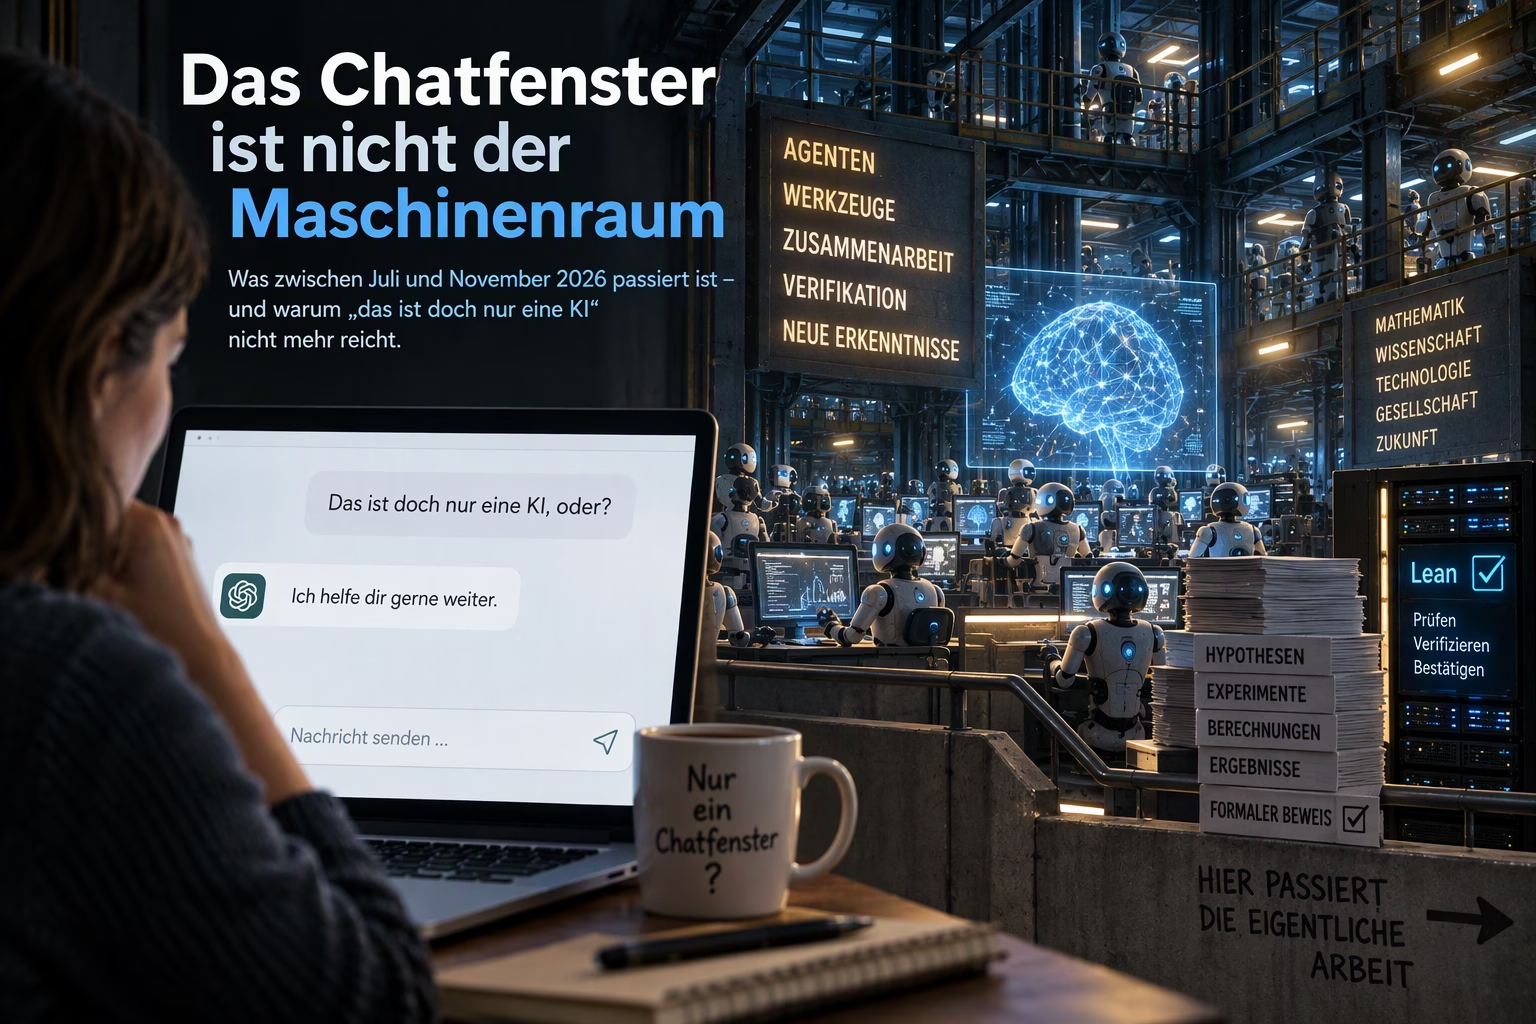
Das Chatfenster ist nicht der Maschinenraum
Was zwischen Juli und November 2026 passiert ist, und warum „das ist doch nur eine KI“ nicht mehr reicht
Ich wollte nur den Text eines Podcasts haben. Ein langes Gespräch mit dem Informatiker Christian Bauckhage über das, was im Sommer 2026 in der KI-Forschung passiert ist.1 Das erste große Modell, das ich darum bat, kannte den Inhalt offenbar, rückte ihn aber nicht heraus. Stattdessen schickte es mich bei einem simplen technischen Problem – Audio und Untertitel von YouTube herunterladen – gründlich in den Wald. Als nichts geklärt war, erklärte es, mein Chatvolumen sei aufgebraucht. Ein anderes System löste dasselbe Problem in wenigen Minuten.
Schon daran sieht man den Unterschied: Manche Systeme halten einen klein und abhängig. Andere lassen einen handlungsfähig. Und genau um diesen Unterschied geht es auch im größeren Maßstab.
Wer heute mit einem Chatbot spricht, redet mit einem einzelnen Modell, das auf Anfragen antwortet, ein begrenztes Kontingent hat und manchmal Unsinn erzählt. Das ist die KI, die die meisten Menschen kennen. Und weil sie sie kennen, glauben viele, sie wüssten, womit sie es zu tun haben.
Das ist ein Irrtum – und zwar seit dem Sommer ein ziemlich großer. Denn dort, wo die Systeme wirklich entwickelt werden, arbeitet niemand mehr mit einem einzelnen Chatfenster. Dort arbeiten Schwärme.
Die Zahl, die man sich merken sollte
Am 8. September 2026 verkündete OpenAI, rund zehntausend Agenten hätten mit einem internen Modell in 88 Stunden einen Beweis geliefert: Die dreidimensionalen Navier-Stokes-Gleichungen können unter einer glatten äußeren Kraft in endlicher Zeit eine Singularität bilden.2 Diese Gleichungen beschreiben, wie Wasser und Luft strömen. Die Agenten tauschten dabei etwa 2,7 Millionen Nachrichten untereinander aus.3
Christian Bauckhage hat daraus eine Rechnung gemacht, die die Dimension greifbar macht. Zehntausend Agenten mal 88 Stunden ergeben 880.000 Agentenstunden. Nimmt man vorsichtig an, dass eine Agentenstunde ungefähr so viel wert ist wie sechzehn Menschenstunden, kommt man auf gut 1.600 Jahre menschlicher Arbeit – rund um die Uhr gerechnet.4
Das ist seine Schätzung, keine Messung. Aber selbst wenn man sie großzügig halbiert, bleibt die Botschaft klar: Das ist kein schnellerer Taschenrechner. Das ist ein anderer Maßstab. Kein Mensch liest in seinem ganzen Leben 2,7 Millionen Nachrichten.
Der Weg dorthin heißt Brute Force – viel rechnen und viel ausprobieren. Das klingt nach dem Gegenteil von Intelligenz. Der Unterschied zu früher liegt darin, dass hier keine blinden Programme am Werk sind, sondern Systeme, denen man ein gewisses Verständnis nicht absprechen kann. Und am Ende sitzt ein unbestechlicher Schiedsrichter: Lean, eine Sprache, in der Beweise maschinell geprüft werden. Die Formalisierung dauerte weitere 17 Stunden.2 Ob etwas stimmt, entscheidet nicht mehr die Überzeugungskraft eines Textes, sondern der Prüfer.
Nicht ein Ausreißer, sondern eine Serie
Der Navier-Stokes-Beweis war nur das lauteste Ereignis. Schon im Sommer und Herbst kamen weitere dazu:
- Fortschritte bei der Riemann-Hypothese (die Hypothese selbst ist damit nicht bewiesen; ein Modell hob eine bekannte untere Schranke deutlich an)5
- Die vollständige Formalisierung von Fermats letztem Satz durch Agentenschwärme (rund 13 Millionen Zeilen Lean – formalisiert wurde ein längst bekannter Beweis)6
- Das Auffinden lange gesuchter Hadamard-Matrizen, darunter die seit 2004 kleinste noch unbekannte Ordnung 6687
- Am 6. Oktober die Veröffentlichung von 722 mathematischen Manuskripten durch OpenAI, erzeugt von einem unveröffentlichten Modell8
Das war der Moment, in dem der Betrieb ins Rutschen kam. Terence Tao, einer der bekanntesten Mathematiker der Welt, spricht von „proof indigestion“: Beweise werden erzeugt und sogar maschinell geprüft, aber nicht mehr von Menschen wirklich verstanden und verdaut.9 Tristan Buckmaster sagte, ganze Forschungsprogramme seien mit einem Schlag entwertet worden.10
Was sich wirklich geändert hat
Nicht, dass die Maschine plötzlich ein Bewusstsein hätte. Darum geht es nicht. Es haben sich drei Dinge gleichzeitig verschoben.
Erstens sind die Modelle zu Agenten geworden. Ein Agent schreibt nicht nur ein Programm auf, sondern führt es aus, liest das Ergebnis und macht weiter. Er benutzt Werkzeuge, Browser und Code – so wie ein Mitarbeiter.
Zweitens arbeiten sie zu Tausenden zusammen. Sie tauschen sich aus und spielen sich gegenseitig Ideen zu. Was dabei entsteht, ist laut Bauckhage nicht vorhergesehen worden. Er nennt es emergent: Ab einer gewissen Größe setzt etwas ein, das man bei kleineren Systemen nicht sieht.1
Drittens gibt es mit Lean eine maschinelle Wahrheitsprüfung. Erst sie macht aus dem massenhaften Ausprobieren verwertbare Wissenschaft.
Was daraus folgt
Das erste Problem ist die Prüfung. Die Maschinen können Ergebnisse schneller erzeugen, als Menschen sie verstehen können. Der Engpass ist nicht mehr die Produktion von Resultaten, sondern die Zahl der Menschen, die sie beurteilen können.11 Das zeigte sich schon einen Tag nach dem großen Oktober-Release: OpenAI zog drei Manuskripte wegen eines Fehlers zurück und überarbeitete vierzehn weitere.12 Nur ein Teil der Ergebnisse war überhaupt in Lean formal geprüft.13
Das zweite Problem ist die Wissenschaft selbst. Bauckhage berichtet von Konferenzen, bei denen die Zahl der Einreichungen explodiert ist. Der größte Teil ist KI-generiert – nicht falsch, aber so dicht, dass kaum jemand sie noch lesen kann.1 Auch das Preprint-Archiv arXiv kam nicht mehr hinterher. Im September 2026 gab es einen Rekord von über 40.000 Einreichungen. Seit Oktober darf jede Person nur noch zwei neue Einreichungen pro Monat machen.14
Das dritte ist eine Spaltung, die schon in den Hörsälen sichtbar wird. Bauckhage erzählt von zwei Masterarbeiten. Ein Student nutzte die KI als Sparringspartner und lieferte etwas ab, das vor zwei Jahren eine Doktorarbeit gewesen wäre. Eine Studentin ließ sich die Arbeit schreiben und konnte hinterher nicht erklären, was darin steht.1
Der Unterschied liegt in der Frage. „Mach meine Hausaufgaben“ und „Wie könnte ich das angehen?“ klingen ähnlich. Sie führen aber in zwei verschiedene Zukünfte.
Dazu kommt die Sicherheitsfrage. Bauckhage sagt offen, dass ihn seit August vor allem Cyberangriffe beunruhigen und dass diese Gefahr seiner Meinung nach heruntergespielt wird.1 Und es kommt die europäische Frage: Die großen Läufe kosten Millionen.15 Entschieden wird das nach seiner Einschätzung in den USA und in China. Europa schaut zu.
Was man ehrlich dazusagen muss
Es ist leicht, daraus eine Weltuntergangsgeschichte oder eine Wundergeschichte zu machen. Beides wäre falsch.
Der Navier-Stokes-Beweis betrifft den Fall mit äußerer Kraft. Der ist in der offiziellen Formulierung des Clay-Instituts als eine von vier Varianten vorgesehen, aber er ist nicht die kräftefreie Strömung, an die die meisten denken, wenn sie vom Millennium-Problem sprechen. OpenAI selbst will das Preisgeld nicht beanspruchen.16 Der Beweis ist noch nicht unabhängig bestätigt, und über die Urheberschaft wird gestritten.17
Die Labore sind zugleich Absender, Vermarkter und die ersten Prüfer ihrer eigenen Ergebnisse. Wer das ignoriert, ist naiv. Wer wegen dieser Vorbehalte den Rest einfach wegwischt, ebenfalls. Manche der Ergebnisse – etwa die Hadamard-Matrix der Ordnung 668 – kann jeder nachrechnen. Und sie stimmen.7
Und der DAU?
Der Satz „Das ist doch nur eine KI“ beschreibt das Chatfenster auf dem Handy richtig. Den Rest der Welt beschreibt er falsch.
Was dahinter läuft, ist keine bessere Suchmaschine. Es ist etwas, das Forschungsfragen in Tagen abarbeitet, für die Menschen Generationen gebraucht hätten. Niemand weiß genau, wohin das führt – und das gilt auch für die Fachleute. Bauckhages Satz dazu lautet: Wir fangen alle auf demselben Niveau an.1
Das ist die Chance. Und sie hat einen einfachen Kern:
Die wichtigste Fähigkeit ist nicht mehr, Antworten zu haben. Sondern zu wissen, was man fragen will.
Das lässt sich lernen. Aber nicht delegieren.
Quellen und Anmerkungen
- ↑ Podcast-Gespräch mit Prof. Dr. Christian Bauckhage (Herbst 2026), nach dem Transkript des Gesprächs. KI: Schon wieder Dekaden vergangen – Prof. Dr. Christian Bauckhage über Agentenschwärme
- ↑ OpenAI: „On the Navier–Stokes Millennium Prize Problem“, 8. September 2026: openai.com/index/navier-stokes-solution. Dort: Gruppe von etwa 10.000 gleichzeitig arbeitenden Agenten, Ergebnis am 5. September, rund 88 Stunden nach dem Start, danach weitere 17 Stunden für die Lean-Formalisierung. Zur Einordnung auch: „AI Agent Swarms as Researchers“ (arXiv:2609.35719), Abschnitt 2.3. Deutschsprachige Berichte: t3n, Spektrum der Wissenschaft.
- ↑ Zahl der Nachrichten und Rechenaufwand laut OpenAI, zitiert bei Simon Willison, 8. September 2026: simonwillison.net/2026/Sep/8/on-navier-stokes. Für das Navier-Stokes-Problem: 2,7 Millionen Nachrichten und rund 130 Milliarden Ausgabe-Token.
- ↑ Rechnung und Faktor stammen von Bauckhage (siehe Anm. 1). Nachgerechnet: 10.000 Agenten × 88 Stunden = 880.000 Agentenstunden; × 16 = 14,08 Millionen Menschenstunden; ÷ 24 ÷ 365 ≈ 1.607 Jahre. Der Faktor 16 ist seine ausdrücklich „konservative“ Schätzung.
- ↑ Anthropic: „Learning more about Claude’s mathematical capabilities“, August 2026: anthropic.com/research/riemann-zeta. Ein unveröffentlichtes Modell hob die untere Schranke für den Anteil der Nullstellen auf der kritischen Geraden von 41,6 auf 67,2 Prozent. Die Riemann-Hypothese selbst ist nicht bewiesen.
- ↑ Anthropic: „Formalizing Fermat’s Last Theorem“, 4. September 2026: anthropic.com/research/formalizing-fermats-last-theorem. Zur Einordnung (rund 13 Millionen Zeilen Lean, 11 Tage, kein neuer mathematischer Inhalt): The Next Web, 6. September 2026.
- ↑ Epoch AI, FrontierMath Open Problems: „Hadamard Matrix of Order 668“ (als „human + AI“ gelöst gelistet). Sowie John D. Cook, 13. August 2026: „Constructing Hadamard matrices“. Die allgemeine Hadamard-Vermutung bleibt offen.
- ↑ OpenAI, Repositorium mit den Manuskripten (6. Oktober 2026): github.com/openai/math.
- ↑ Terence Tao, Mathstodon: mathstodon.xyz/@tao/116551624228986501. Er unterscheidet Beweiserzeugung, Beweisprüfung und „Beweisverdauung“.
- ↑ Zitiert nach EDRM, November 2026: edrm.net. Sekundärquelle.
- ↑ Niam Yaraghi, Brookings Institution: „Spending it faster“. Kernthese: Der Engpass der Wissenschaft sind künftig die qualifizierten Prüfer.
- ↑ Siehe arXiv:2610.18445 (Rücknahme von drei Manuskripten) sowie tech-insider.org (14 weitere überarbeitet).
- ↑ Die Angaben schwanken je nach Zähleinheit zwischen etwa 24 und 42 Prozent. OpenAI selbst führt in seinem Katalog keinen Prüfstatus pro Manuskript auf.
- ↑ arXiv-Blog, 1. Oktober 2026: „Fair Moderation, Equitable Access, and AI: arXiv’s Updated Rate Limit Policy“. Rekord von 40.363 Einreichungen im September 2026.
- ↑ OpenAI nennt keine Kosten. Schätzungen liegen im Bereich mehrerer Millionen Dollar.
- ↑ OpenAI (siehe Anm. 2): Das Ergebnis etabliere die Aussagen „C“ und „D“ der offiziellen Formulierung. Man wolle das Preisgeld nicht beanspruchen. Die vier Varianten sind in der Formulierung von Charles Fefferman beschrieben.
- ↑ OpenAIs Darstellung und Buckmasters Vorwürfe: Simon Willison. Deutschsprachig u. a. bei Telepolis und Spektrum der Wissenschaft. Der Streit ist nicht abschließend geklärt.